Streaming-UIs gestalten
Die Streaming-Ausgabe ist die neue Leinwand. Ein praxisnahes Playbook, um KI-Streaming-UIs als echtes Interaktionsmodell zu gestalten: mit fünf Ebenen, echten Produkt-Teardowns, Anti-Patterns und einem Audit vor dem Launch.
Die Streaming-Antwort ist die am schlechtesten gestaltete Oberfläche in moderner Software. Die meisten Teams haben einen TypeScript-Fetch-Hook gebaut, ihn an ein div gehängt und das Produktdesign genannt. Das Ergebnis: eine Schreibmaschine, die so tut, als wäre sie ein Interface.
Streaming ist nicht einfach Text, der erscheint. Es ist ein Interaktionsmodell mit Rhythmus, Pausen, Scroll-Verhalten, Unterbrechungs-Affordanzen und Vertrauenssignalen. Ein Team, das nur den Input gestaltet, hat ein halbes Produkt ausgeliefert. Der Output-Bereich ist die andere Hälfte, und genau dort verlieren die meisten KI-Produkte ihre Nutzer.
Dieser Beitrag ist die operative Version. Was ein Streaming-UI wirklich ist, die fünf Ebenen, die jedes gute ausliefert, echte Teardowns, die Anti-Patterns, die Oberflächen im Live-Betrieb killen, und ein Audit vor dem Launch.
Ein Streaming-UI ist eine Oberfläche, keine Fetch-Schleife
Ein Streaming-UI ist der gesamte Bereich, aus dem der Nutzer liest, während das Modell läuft. Der sichtbare Text ist nur ein Teil. Die Kadenz, der Cursor, das Scroll-Verhalten, die strukturellen Festlegungen, die Unterbrechungs-Steuerung und der Zustand nach dem Stream sind der Rest.
Die Oberfläche hat messbare Eigenschaften. Time-to-first-token. Token-Kadenz. Strukturelle Festlegung. Unterbrechungs-Latenz. Abschlusssignal. Affordanzen nach dem Stream. Ignorierst du eine davon, ist der Stream ein Nebeneffekt einer API und keine gestaltete Komponente.
Cursor, Claude, v0, Lovable, Linear AI, Raycast AI. Keines behandelt Streaming als rohe Token-Ausgabe. Jedes liefert eine strukturierte Oberfläche. Das ist die Messlatte.
Die fünf Ebenen einer großartigen Streaming-Oberfläche
Fünf Ebenen, in der Reihenfolge, in der der Nutzer sie erlebt. Ein Streaming-UI mit weniger als vier ist unvollständig.
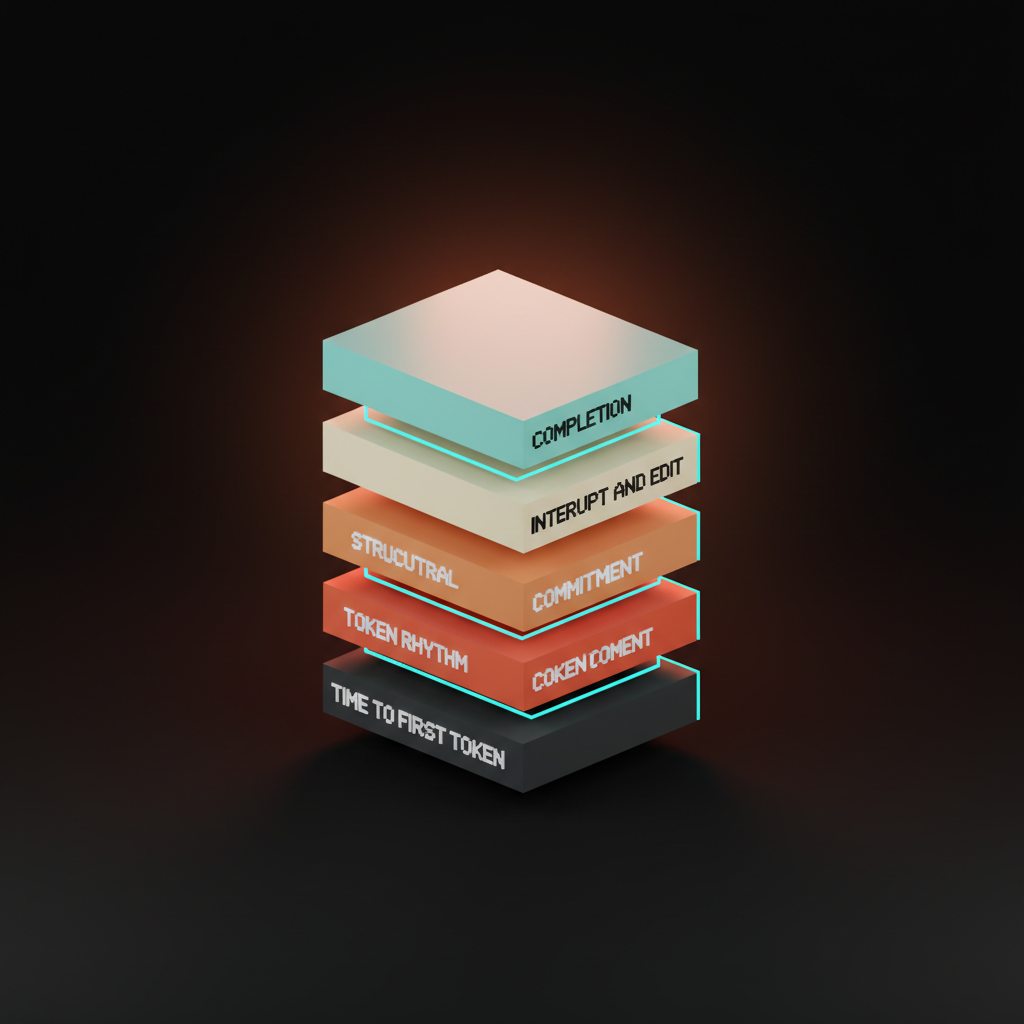
Time-to-first-token ist der Moment, in dem aus der Leere Feedback wird. Der Token-Rhythmus ist das Gefühl des laufenden Streams. Strukturelle Festlegung beschreibt, wie die Oberfläche Listen, Tabellen und Code ohne Re-Flow behandelt. Unterbrechen und Bearbeiten ist der Notausgang des Nutzers. Der Abschluss ist der Moment, in dem der Stream endet und das Artefakt interaktiv wird. Lässt du eine Ebene weg, fault der Stream ab dieser Ebene nach oben.
Ebene 1: Time-to-first-token
Die ersten 200 Millisekunden entscheiden, ob der Nutzer der Oberfläche vertraut. Unter 200 ms mit echtem Feedback-Signal fühlt sich sofort an. Nach 800 ms ohne Feedback hat der Nutzer schon beschlossen, dass das Produkt kaputt ist.
Die Optionen sind konkret. Ein Skeleton-Platzhalter, der den Ausgabebereich vorab reserviert. Ein blinkender Cursor. Eine Typing-Dots-Affordanz. Ein Streaming-Präfix, bei dem eine bekannte Phrase wie „Hier ist“ nach 300 ms landet, bevor der Inhalt kommt.
Die drei Punkte von ChatGPT funktionieren, weil sie ehrlich sind. Claudes Gradient-Puls ist das Upgrade: ein weiches animiertes Band, das signalisiert, dass die Oberfläche lebt, ohne sich auf Fake-Inhalt festzulegen. Cursor rendert eine dünne Cursor-Linie und einen Status-Chip, der benennt, was gerade passiert. In jedem Fall sieht der Nutzer innerhalb von 200 ms etwas.
Die Leere ist der Fehler. Ein leerer Bereich, der 600 ms hängt, bringt dem Nutzer bei, dass KI etwas ist, das man aussitzt. Liefere den Cursor aus, bevor du das Modell auslieferst.
Ebene 2: Token-Rhythmus
Rohe Token-Streams ruckeln. Ein Modell, das vier Tokens ausgibt, dann zwanzig, dann eins, sieht aus wie ein flackerndes Terminal, selbst wenn die Auslieferung darunter einwandfrei ist. Rhythmus ist eine Designentscheidung.
Die Lösung ist eine geglättete Kadenz. Puffere eingehende Tokens 30 bis 60 Millisekunden und rendere dann in gleichmäßigem Tempo. Der Nutzer liest 250 bis 400 Wörter pro Minute, also ist das Ziel ein Stream, der auf oder knapp über Lesegeschwindigkeit landet, ohne Spitzen. Claude hat diese Disziplin früh ausgeliefert.
Vercels Streaming-UI-Primitives in v0 setzen dieselbe Idee um: eine Render-Schleife, die das Netzwerk vom visuellen Update entkoppelt. Der Token-Stream von der API ist eine Ebene. Der visuelle Stream ist eine andere. Beide sollten nie dasselbe sein.
Der Cursor zählt. Ein Cursor, der dem zuletzt gerenderten Token folgt, mit weichem Nachzieh-Fade, verankert das Auge. Ohne ihn springt der Blick umher und sucht, wo der Stream gerade ist. Dass Cursors Cursor im Composer so heißt, ist kein Zufall.
Ebene 3: Strukturelle Festlegung
Die schwerste Ebene. Flacher Fließtext ist leicht. Ein Stream, der sich mitten in der Antwort auf Liste, Tabelle, Codeblock oder Diagramm festlegt, ist der Punkt, an dem die meisten Oberflächen brechen.
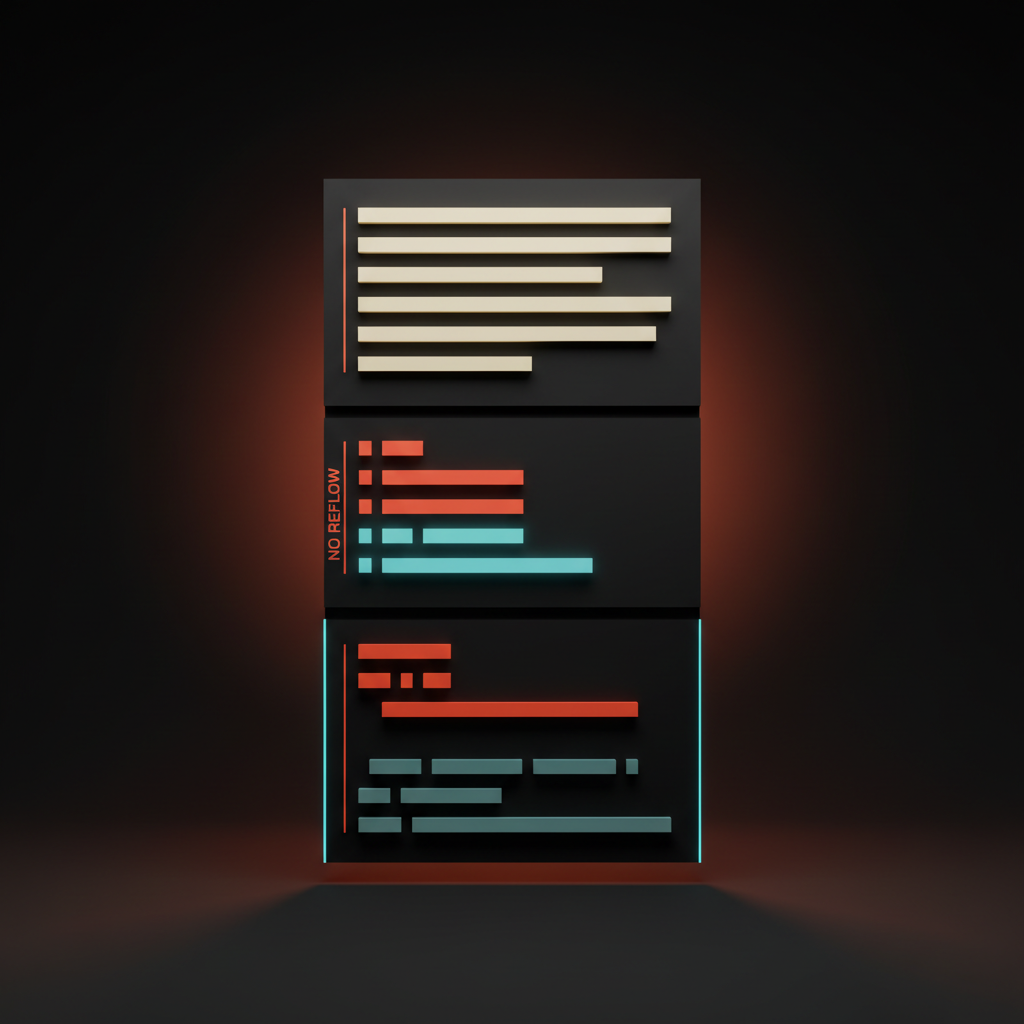
Die naive Version ist Markdown-als-Streaming. Der Renderer parst jeden Chunk, das Layout fließt bei jedem Commit neu, die Liste nummeriert sich um, der Codeblock wechselt mitten im Stream die Schrift, die Seite springt. Jeder Reflow ist eine Steuer auf Aufmerksamkeit.
Die richtige Version legt Struktur fest, sobald sie erkennbar ist, und streamt den Inhalt dann ohne Re-Flow ins festgelegte Layout. Eine Liste reserviert Platz, sobald der erste Bindestrich landet. Ein Codeblock reserviert ein Monospace-Pane beim Triple-Backtick. Eine Tabelle legt die Spaltenanzahl sofort fest. Cursors Diff-Streaming ist der Lehrbuchfall. Das Diff-Pane reserviert Layout, Dateipfade landen zuerst, einzelne Zeilen streamen in vorab angelegte Zeilen. v0s selektionsbewusstes Streaming setzt dasselbe Muster auf der Canvas-Seite um.
Linear AIs strukturierte Vorschläge liefern Festlegung, ohne dem Nutzer je einen „Lädt“-Zustand zu zeigen. Der Vorschlag landet als typisiertes Objekt, Felder füllen sich in Abhängigkeitsreihenfolge, der Workflow blockiert nie. Linear liefert Arbeit, die anderen liefern Transkripte.
Ebene 4: Unterbrechen und Bearbeiten
Ein Streaming-UI ohne Unterbrechung ist feindselig. Der Nutzer sieht dem Modell dabei zu, wie es etwas schreibt, von dem er schon weiß, dass es falsch ist, und der einzige Ausweg ist, den Tab zu schließen. Kein Produkt. Eine Geiselnahme mit Token-Zähler.
Der Stopp-Button ist das billigste Element mit dem größten Hebel auf der Oberfläche. Sichtbar ab Token eins, nicht erst nach Token 100. Claude, Cursor, ChatGPT und v0 haben einen. Die meisten selbstgebauten Chat-UIs vergessen ihn.
Unterbrechen ist der Boden. Bearbeiten ist die Decke. Das Muster, das sich die meisten Teams noch nicht verdient haben, ist die Live-Bearbeitung, bei der der Nutzer den Prompt mitten im Stream überarbeitet und die Oberfläche umlenkt. Cursors Accept und Reject während des Streamings ist die nächstliegende ausgelieferte Version. Der Nutzer liest das Diff, während es landet, übernimmt, was funktioniert, und verwirft, was nicht. Das ist eine echte Interaktionsschleife.
ChatGPTs Regenerate ist der Gegenentwurf. Der Button überschreibt die vorherige Antwort, der Nutzer verliert die Version, die ihm gefiel. Regenerate als Überschreiben ist destruktiv. Regenerate als Branch ist Design. Claudes Verlaufsoberfläche liefert den Branch.
Ebene 5: Abschluss und Zustand nach dem Stream
Der Moment, in dem der Stream endet, ist ein Design-Moment. Die meisten Produkte behandeln ihn als Nichts. Der Stream stoppt, der Cursor verschwindet, der Nutzer starrt auf eine Textwand und fragt sich, was er als Nächstes tun soll.
Claudes Artifact-Materialisierung ist der Goldstandard. Der Streaming-Text bekommt ein leises Abschlusssignal, und das Artifact-Pane wechselt im selben Takt von der Streaming-Vorschau zur interaktiven Oberfläche. Der Nutzer ist nicht „fertig mit Lesen“, er ist jetzt „im Artifact“. Der Übergang ist der ganze Punkt.
v0s Preview-Swap ist die Design-seitige Version. Der Streaming-Code endet, das Live-Preview-iframe lädt mit dem finalen Build neu, der Deploy-Button erscheint. Drei Zustände, ein Übergang, keine Leerlaufzeit.
Cursors Diff-to-Accept ist das dritte Muster. Der Stream endet, das Diff bleibt editierbar, Accept und Reject bleiben, die Datei wird erst committet, wenn der Nutzer es sagt. Der Stream ist vorbei, die Entscheidung nicht. Diese Trennung lässt die Oberfläche wie ein Werkzeug wirken statt wie ein Chatprotokoll.
Die schlechte Version beendet den Stream und liefert nichts. Der Cursor blinkt aus, der Text liegt da, der Nutzer kopiert ihn in ein anderes Tool, um ihn tatsächlich zu nutzen. Eine Copy-Paste-Pipeline mit angeschlossenem Modell.
Echte Produkt-Teardowns
Cursor fährt Composer-Streaming plus Diff-Materialisierung. Der Composer streamt den Plan, das Diff-Pane streamt den Patch, Accept und Reject bleiben live, der Zustand nach dem Stream ist ein ausstehendes Diff, das dem Nutzer gehört. Jede Ebene sitzt.
Claude liefert geglätteten Token-Rhythmus und Artifact-Pane-Swap. Gradient-Puls vor dem ersten Token, gleichmäßige Kadenz, Artifact-Materialisierung beim Abschluss, Gesprächsverlauf mit Branches. Die Oberfläche wirkt gestaltet, weil jeder Übergang es war.
v0 liefert selektionsgetriebenes Streaming mit Live-Preview. Der Nutzer klickt eine Region des Canvas, der Prompt grenzt sich selbst ein, der Stream landet als Code und als Preview-Swap im iframe. Der Abschluss übergibt an einen Deploy-Button.
ChatGPT ist die Baseline. Token-Streaming mit Drei-Punkte-Feedback, Regenerate als Überschreiben, Branch-from-here als neue Ergänzung. Kategorie-Standard, nicht die Messlatte.
Vercel AI Playground, Lovable, Anthropic Computer Use, Raycast AI und GitHub Copilot Workspace liefern jeweils Ausschnitte. Vercel zeigt die Modellauswahl live während des Streams. Lovable fährt das Stream-to-App-Muster, der Nutzer sieht seine App in Echtzeit entstehen. Computer Use streamt Screenshots und Reasoning-Trace parallel. Raycast streamt in eine Command-Palette-Mikrooberfläche. Copilot Workspace liefert Plan-dann-Ausführen-Streaming mit Checkpoints.
Die fünf Regeln
- Zeige Feedback unter 200 Millisekunden. Ein Cursor, ein Puls, ein Typing-Punkt, ein Streaming-Präfix. Alles außer der Leere.
- Glätte die Kadenz. Puffere den Netzwerk-Stream, rendere in Lesegeschwindigkeit, verankere den Cursor. Jitter ist ein Designfehler, kein Netzwerkzustand.
- Lege Struktur ohne Re-Flow fest. Reserviere Layout, sobald eine Liste, Tabelle oder ein Codeblock erkennbar ist. Niemals reflowen.
- Liefere den Stopp-Button vor Token 100. Sichtbar. Erreichbar. Ein Klick. Keine Ausnahmen.
- Gestalte den Moment nach dem Stream so sorgfältig wie den Stream. Der Abschluss ist eine Übergabe. Die Übergabe ist das Produkt.
Die Anti-Patterns, die Streams im Live-Betrieb killen
Der tote Spinner. Ein Spinner läuft, während das Modell hinter einer geschlossenen Render-Ebene streamt. Lösche den Spinner. Liefere den Stream.
Der Token-Jitter. Rohe Token-Ausgabe, kein Puffer, die Kadenz flackert zwischen Schüben und Pausen. Glätte sie.
Das Auto-Scroll, das gegen den Nutzer kämpft. Die Seite scrollt automatisch dem Stream hinterher, während der Nutzer einen früheren Absatz liest. Erkenne manuelles Scrollen und pausiere Auto-Scroll, bis der Nutzer wieder andockt. Claude und Cursor lösen das.
Der Kein-Stopp-Button-Fehler. Unterbrechen ist in einem Einstellungsmenü vergraben, erscheint erst nach 30 Sekunden oder existiert gar nicht. Sichtbar ab Token eins.
Der Stream, der endet und den Nutzer ratlos zurücklässt. Kein Abschlusssignal, kein nächster Schritt. Gestalte den Zustand nach dem Stream.
Das destruktive Regenerate. Die neue Antwort überschreibt die alte, der Nutzer verliert die Version, die ihm gefiel. Regenerate als Branch, nie als Überschreiben.
Rohes Markdown als Streaming. Der Renderer reflowt bei jedem Chunk, die Seite springt. Lege Struktur einmal fest, streame ins reservierte Layout.
Die Fixes sind klein. Oberflächen, die sie ausliefern, fühlen sich nach 2026 an. Oberflächen ohne sie fühlen sich an wie Chat-Sidebars von 2022, angeschlossen an ein Modell von 2026.
Das Streaming-Oberflächen-Audit
Führe diese Checks bei jeder KI-Streaming-Oberfläche durch, bevor sie live geht.
- Erstes Feedback. Zeigt die Oberfläche innerhalb von 200 Millisekunden nach dem Absenden etwas an?
- Kadenz. Ist der Token-Stream auf Lesegeschwindigkeit geglättet oder rohes Netzwerk-Jitter?
- Strukturelle Festlegung. Reserviert die Oberfläche Layout für Listen, Tabellen und Codeblöcke, bevor der Inhalt ankommt?
- Stopp-Affordanz. Ist der Stopp-Button ab dem ersten Token sichtbar und mit einem Klick erreichbar?
- Bearbeiten-Affordanz. Kann der Nutzer mitten im Stream überarbeiten, übernehmen oder verwerfen?
- Abschluss-Design. Übergibt der Moment, in dem der Stream endet, an einen echten nächsten Schritt?
- Artifact nach dem Stream. Ist die Ausgabe nach dem Stream interaktiv oder nur ein eingefrorenes Transkript?
Eine Oberfläche, die alle sieben besteht, wirkt wie eine gestaltete Komponente. Eine, die drei oder mehr verfehlt, wirkt wie ein Konsolen-Log mit angeschlossenem Modell. Dieser Abstand trennt AI-natives Produktdesign von angeflanschter KI.
Die Teams, die Streaming-Oberflächen so sorgfältig ausliefern, sind dieselben, die Prompt-Oberflächen auf der Input-Seite als echte Komponenten behandeln und auf Systemebene für KI-Latenz gestalten. Kombiniere es mit Empty States, Agent-UI-Mustern und Vertrauenssignalen, damit die Streaming-Ausgabe sich das Gelesenwerden verdient.
FAQ
Was ist Streaming-UI-Design?
Streaming-UI-Design ist die Disziplin, zu gestalten, wie KI-Ausgabe auf dem Bildschirm erscheint, während das Modell sie generiert. Es umfasst Time-to-first-token, Token-Kadenz, strukturelle Festlegung, Unterbrechungs-Affordanzen und das Artifact nach dem Stream. Ein Streaming-UI ist keine Textarea, die sich mit Text füllt. Es ist eine gestaltete Oberfläche mit messbaren Eigenschaften, und die Produkte, die gerade gewinnen, behandeln sie auch so.
Warum fühlt sich Token-Streaming in verschiedenen Produkten unterschiedlich an?
Weil Kadenz eine Designentscheidung ist, kein Netzwerkergebnis. Ein roher Token-Stream ruckelt. Ein gepufferter, geglätteter Stream landet in Lesegeschwindigkeit. Claude glättet die Kadenz mit einer Render-Schleife, die das Netzwerk vom visuellen Update entkoppelt. ChatGPT liegt näher an roher Auslieferung. Gleiche Modellklasse, anderes Oberflächengefühl.
Was ist der häufigste Streaming-UI-Fehler?
Einen Stream ohne sichtbaren Stopp-Button auszuliefern. Der Nutzer sieht dem Modell beim Schreiben von etwas zu, das er für falsch hält, und hat keinen Ausweg. Weitere häufige Fehler: tote Spinner, Auto-Scroll, das gegen den Nutzer kämpft, destruktives Regenerate, rohes Markdown, das bei jedem Chunk reflowt, und ein Abschluss, der an nichts übergibt. Jeder davon lässt sich mit einer kleinen Änderung an der Oberfläche beheben.
Baue den Stream, als wäre er die Leinwand
Die Streaming-Ausgabe ist die neue Leinwand. KI-Produkte leben oder sterben daran, wie sich diese Oberfläche in den ersten 800 Millisekunden anfühlt und wie lesbar sie über eine 30-sekündige Antwort bleibt. Die meisten Teams behandeln sie wie eine Schreibmaschine. Die Teams, die die Messlatte setzen, behandeln sie wie Infrastruktur.
Liefere die fünf Ebenen. Fahre das Audit. Vermeide die Anti-Patterns. Das Produkt, das am Ende herauskommt, fühlt sich an wie ein Werkzeug statt wie eine Chat-Sidebar, die eines zu sein vorgibt.
Wenn du ein Team willst, das Streaming-Oberflächen als vollwertige Komponenten ausliefert statt als angeflanschte Token-Schleifen, hire Brainy. Wir gestalten AI-native Produkt-UI von Anfang bis Ende, vom ersten Token bis zum Artifact nach dem Stream, mit eingebauten Vertrauenssignalen und Unterbrechungs-Affordanzen, noch bevor der erste Nutzer auf Senden drückt.
Want a streaming surface that feels designed instead of bolted on? Brainy ships AI-native product UI end to end, from the first token to the post-stream artifact.
Get Started