信任设计:AI 产品如何在前 5 分钟内赢得或失去用户信心
一份把信任设计进 AI 产品的实战手册。对 Claude.ai、Cursor、Granola、Perplexity、Linear AI、ChatGPT 和 Notion AI 的真实拆解。六种能在前五分钟赢得信心的信任模式,四种会摧毁信心的反模式,以及一份任何设计师明天就能在 AI 界面上跑一遍的五条清单。
信任是 AI 产品中唯一重要的货币。大多数团队的设计思路却像是用户会白白把它交出来。前五分钟就是整场谈判,而大多数产品在用户意识到谈判正在进行之前,就已经把人丢了。
这是一份实战手册。六种信任模式、四种反模式、七个拆解案例、三个警示故事,以及一份任何设计师明天就能在 AI 界面上跑一遍的五条清单。
信任是 AI 产品中唯一的货币
AI 产品的生死取决于信任,因为用户不亲自做一遍工作就无法验证输出。表格里的错误是看得见的。凭空捏造的会议纪要却看不见。用户把信任交给一个非确定性的系统,而这份信任就是整笔交易。
大多数团队把信任当成营销问题。页脚放个安全徽章,注册时弹个隐私窗口,关于页面写一句负责任的 AI。这些都改变不了用户阅读输出的那个界面里发生的事。信任是 UX 问题,有具体的模式可循。
前五分钟就是整场谈判
用户决定是否信任一个 AI 产品的窗口很短。大约五分钟,有时更短。在这段时间里,他们默默地检验每一条输出,看有没有幻觉、有没有免责说明、有没有来源。通过了,他们就把产品当工具来用。没通过,他们就把它记成又一个 AI 噱头。
这场谈判有规则。推理胜过自信。来源胜过文采。委婉的拒绝胜过自信满满的错误答案。可逆性胜过安全作秀。
真正管用的六种信任模式
六种模式把赢得信任的 AI 产品和假装赢得信任的产品区分开来。答案之前先展示推理。说明模型及其局限。引用界面。置信度信号。可逆性。人在回路。
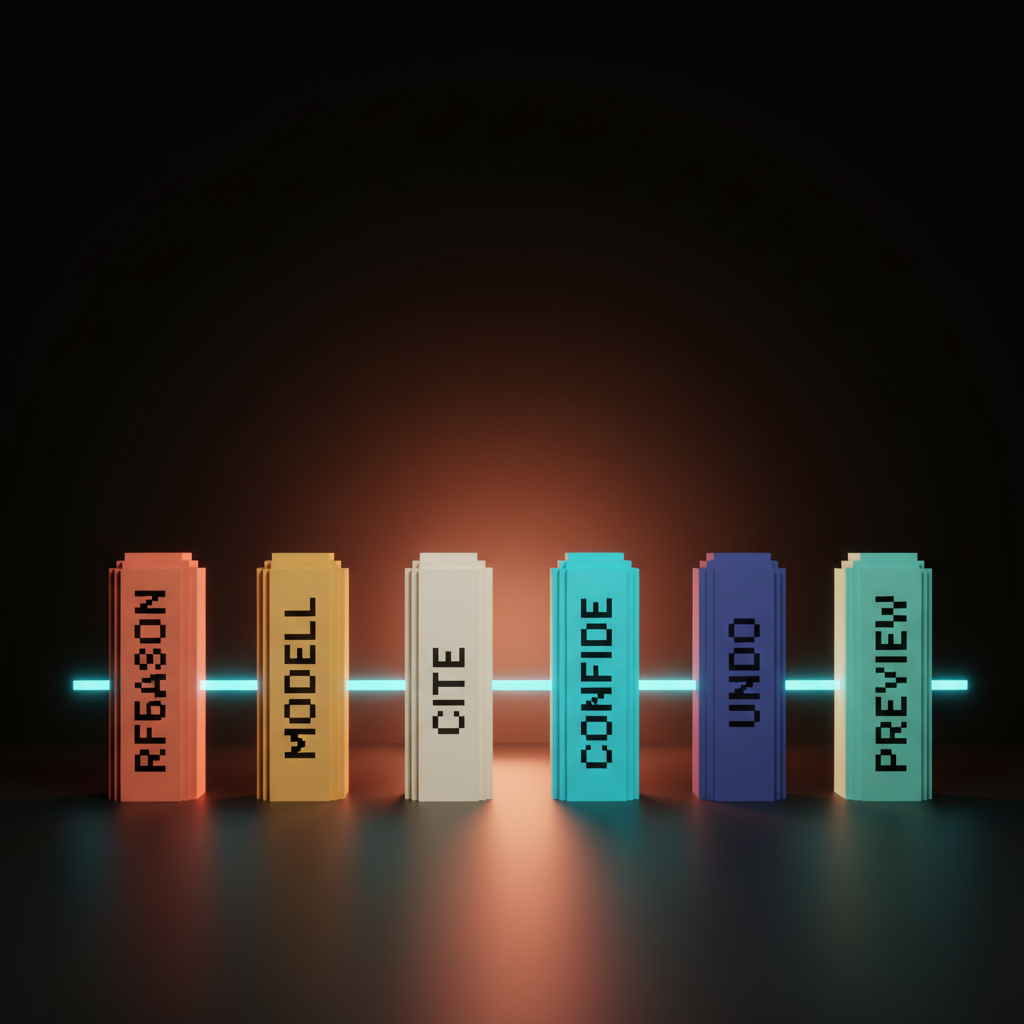
只选三个,用户会注意到缺失的另外三个。六个全选,产品才像一个队友。每个 AI 产品在上线前都需要对这六项逐一给出结论。
先展示推理,再给出答案
第一种模式是在答案出现之前展示模型的思考过程。用户更信任自己亲眼看着成形的答案,而不是凭空冒出来的答案。一个空白的加载圈后面跟着自信满满的大段文字,是 AI 产品能给出的最糟糕的第一印象。
Claude.ai 的 extended thinking 做得很好。用户能看到模型把推理说出来,抛出想法,排除它们,逐步收敛。等答案落地时,用户已经看过整个过程,读到的是结论而不是宣告。Perplexity 用的是更温和的版本,在综合答案之前先流式输出来源。无论哪种方式,用户都是先拿到收据,再拿到判决。
说明模型是谁,以及它的局限
第二种模式是明确说出是哪个模型在说话、它能做什么。匿名的 AI 就等于匿名的建议。Granola 告诉用户它刚刚听了这场会议。Cursor 告诉用户是哪个模型写了这份 diff。Notion AI 显示模型名称以及它正在读取的范围。
标明模型不花一分钱,却能在每次交互中赢得信任。用户知道自己面对的是快而便宜的模型,还是慢而谨慎的模型,知道模型能访问的是某份特定文档还是公共网络。把这些藏在一个通用的 AI 徽章后面,是偷懒的选择。
引用界面胜过似是而非的文字
第三种模式是为每一个论断展示背后的来源。没有出处的似是而非的文字,是看起来像幻觉工厂的最快方式,哪怕模型是对的。引用把 AI 从神谕变成图书管理员,而用户默认信任图书管理员。
Perplexity 的引用紧挨着每个句子,可悬停查看片段。Granola 的引用是每条摘要要点下方带时间戳的逐字稿。Cursor 的引用是 diff 中带行号的文件引用。形式取决于数据,但每个界面都需要一种。
置信度信号与体面的拒绝
第四种模式是 AI 知道自己什么时候不知道。说出「我不确定」的产品,比一本正经地断言错误内容的产品赢得更多信任。体面的拒绝是一项功能,而把它埋在自信的幻觉下面的产品,正以最快的速度流失信任。
ChatGPT 的做法是持续不断地给出「我可能是错的」的提醒,以及联网浏览时的谨慎警告。Claude.ai 会说「我无法访问那个」,而不是瞎猜。学会在该拒绝的问题上说不的产品,才有资格在其余问题上说是。
可逆性让错误可以承受
第五种模式是撤销、重新生成、回滚。AI 一定会出错,继续使用它的唯一办法就是让出错的代价变低。每个操作都需要一条退路,每个输出都需要一个重新生成按钮。
Cursor 从不在没有 diff 的情况下写下一行代码,用户随时可以拒绝。Linear AI 从不在没有预览的情况下编辑 issue。Notion AI 从不在没有撤销的情况下改写段落。AI 提议,用户裁决,裁决只需一次点击。
人在回路,先预览再提交
第六种模式是在任何破坏性 AI 操作之前设置预览关卡。助手和隐患之间的区别,在于用户能否在改动落地之前看到它。每个会写入数据库、发送消息或编辑文档的 agent,都需要一个可读、可编辑、可拒绝的预览界面。
Cursor 的 diff 预览是代码领域的黄金标准。Linear AI 的变更提议视图是嵌入式产品 AI 的黄金标准。ChatGPT Operator 运行在沙盒浏览器里,用户可以暂停并接管。为了显得更有 agent 感而拿掉预览关卡,就是团队上线一个用户第二周就会关掉的功能的方式。
七个赢得信任的 AI 产品
这些模式只有经受住已上线产品的考验才有意义。以下七个界面,如今都在前五分钟内赢得了用户的信心。
Claude.ai:把 extended thinking 当作收据
Claude.ai 的 extended thinking 在回答之前展示模型的工作过程。用户看着它梳理问题、列出候选路径、排除薄弱的几条,然后收敛。等答案落地时,用户已经读过整个演算。用户不需要逐行阅读,只需要知道工作确实发生过。
Cursor:把 diff 预览当作契约
Cursor 从不在没有先展示 diff 的情况下写代码。agent 的权限止步于用户必须接受的那些绿线和红线。每一次改动都是提议,而不是既成事实。diff 就是契约,而契约让 agent 感觉像一个工具,而不是在你去吃午饭时偷偷编辑你仓库的同事。
Granola:每个论断下面都有带引用的逐字稿
Granola 告诉用户它刚听了会议,并在每条摘要要点下方展示带时间戳的逐字稿。如果 AI 说团队决定下周五发布,用户可以点击那一行,听到确切的那一刻。对音频来说,引用是时间戳。对文档来说,是页码。对代码来说,是行号。
Perplexity:实时流式输出来源
Perplexity 在答案之前先流式输出来源。引用出现在综合答案之前,这让用户明白答案是有根据的,而且可以点进去查看。先来源后答案,比带脚注的答案更能赢得信任。
Linear AI:每个操作都先预览再提交
Linear AI 从不在没有先展示拟议改动的情况下编辑 issue。用户把建议的标题、描述或标签当作草稿查看,一次点击就能接受或拒绝。没有这道关卡,AI 就像漏洞。有了它,AI 就像队友。
想要一个在前五分钟内赢得信任的 AI 产品?雇用 Brainy。UXBrainy 交付信任审计和首次使用流程重设计,AppBrainy 交付内置推理、引用和可逆性的完整 AI 产品,ClaudeBrainy 交付让置信度信号和体面拒绝变得廉价的提示词与 Skill 层。再搭配 AI 产品新手引导和 AI agent UI 设计模式,就是完整的首次使用打磨。
ChatGPT:谨慎浏览与体面的拒绝
ChatGPT 在浏览模式上提供可见的警告,对不确定的查询给出委婉的拒绝,并持续给出「我可能是错的」的提醒。这个产品愿意显得不确定,而这正是赢得信任的 AI 该有的样子。承认自身局限的产品,能让用户熬过第一个错误答案。假装自信的产品,则会失去他们。
Notion AI:标明模型与可见范围
Notion AI 告诉用户是哪个模型在回答,以及 AI 正在读取哪个页面或数据库。每条提示词上的范围标签是在用户数据内部运行的嵌入式 AI 的正确模式。说「我读了这三个页面」的 AI,比对自己看过什么只字不提的 AI 更让用户信任。
摧毁信任的四种反模式
大多数在留存上挣扎的 AI 产品,都会同时踩中这四个信任杀手中的几个。幻觉式自信。不透明的操作。缺失的可逆性。零归因。每一个都会把一次糟糕的输出变成永久的信誉损失。
没有任何提示的幻觉式自信
第一种反模式是 AI 用与已证实事实相同的权威口吻断言不可靠的输出。一个错误的日期,一条捏造的引用,一次对用户数据的自信误读,既没有保留,也没有委婉拒绝。用户抓到一次,就开始手动核实每一条输出。没有置信度校准的 AI,只是打字更快,算不上协助。
用户无法检查的不透明操作
第二种反模式是 agent 做了用户看不到、读不到、验证不了的事。AI 写入文档、编辑 Jira 工单或发出邮件,用户事后才知道,甚至根本不知道。没有操作日志,每个 AI 操作都是一次信仰之跃。请提供可见的日志,每个操作都有时间戳、有归属、可撤销。
不可逆写入缺少可逆性
第三种反模式是让 agent 写入数据库、发送消息或关闭工单,却没有撤销。用户在出问题的那一刻才发现不可逆,而那一刻也是他们最后一次信任这个产品。每次写入都需要预览、撤销或确认关卡。
自信的论断零归因
第四种反模式是交付一段似是而非的文字,没有来源,没有链接,没有文件引用。用户读完,问「这是从哪来的」,却什么也找不到。下一段也因此被当成虚构。每个论断都需要来源。
真实 AI 部署中的三个警示故事
每有一个赢得信任的 AI 产品,就有一个把信任烧光的。企业 AI 助手自信地引用了错误的合同续约日期,迫使法务此后手动核实每一条输出。没有升级通道的客服机器人,把沮丧的用户困在礼貌而自信的循环里,直到他们流失。摘要工具剥掉了每条引语的出处,把内部报告变成无法验证的文字。
三者的模式如出一辙。产品选择了自信的外表,而不是信任的实质。解法也如出一辙。展示过程,标明模型,引用来源,提供撤销。
适用于任何 AI 界面的五条清单
明天就在任何 AI 产品界面上跑一遍。
- 答案之前推理是可见的,或者答案足够短,不需要推理。
- 模型及其范围在界面上标明,而不是埋在设置页里。
- 每个论断都有用户可以点击、悬停或回放的来源。
- 每个破坏性操作在落地之前都有预览、撤销或确认关卡。
- 产品能说「我不知道」,并在不确定的查询上体面地拒绝,而不是自信地瞎猜。
五条。打印出来。贴在墙上。每个 AI 界面上线前都跑一遍。
FAQ
我有多长时间来赢得 AI 产品的用户信任?
从首次到来算起大约五分钟,有时更短。在这段窗口里,用户会默默检验每一条输出,看有没有幻觉、免责说明和来源。通过了,你就留住了他们。没通过,他们会把这个产品记成又一个 AI 噱头。
展示模型的推理会比直接回答更慢吗?
感觉上更快,而不是更慢,因为用户把它当作进展来读。流式的推理轨迹比空白加载圈后面跟一段成品文字来得更早。
AI 产品应该总是引用来源吗?
应该,只要是针对具体数据做事实性论断。形式取决于数据,音频用时间戳,文档用页码,代码用行号。没有出处的似是而非的文字,是看起来像幻觉工厂的最快方式。
处理 AI 的不确定性,正确的做法是什么?
展示出来。自信的错误答案比诚实的「我不确定」损失更多信任。委婉的拒绝和可见的置信度信号是在赢得信任,而不是侵蚀信任。
每个 AI agent 操作都需要撤销吗?
凡是破坏性操作都需要。数据库写入、消息发送、工单关闭、文档编辑。关卡的成本是一次点击。跳过它的代价是整个产品。
信任式设计真正解锁的转变
赢得信任的 AI 产品,不是免责声明写得更好的产品。而是把推理、归因和可逆性当作一等界面来设计的产品。眼下胜出的产品,把信任当作首要的设计问题,而不是法务团队的问题。
大多数团队依然像是用户会白白交出信任那样来设计。走在前面的团队会展示过程,标明模型,引用来源,提供撤销,并学会在值得说的问题上说「我不知道」。把它与 AI 原生产品设计搭配,让信任模式落在一个以模型为界面的产品上,再借助为 AI 延迟而设计,让信任信号之间的等待不会打断这场谈判。
如果你想要一个五分钟赢得信任、而不是两分钟就失去信任的 AI 产品,雇用 Brainy。UXBrainy 交付信任审计和首次使用流程重设计,AppBrainy 交付内置推理、引用和可逆性的完整 AI 产品,ClaudeBrainy 交付让置信度信号和体面拒绝变得廉价的提示词与 Skill 层。
Want an AI product that earns trust in the first five minutes, not the tenth session? Brainy ships UXBrainy as trust audits and first-run redesigns, AppBrainy as full AI product delivery with reasoning, citations, and reversibility built in, and ClaudeBrainy as the prompt and Skill layer that makes confidence signals and graceful refusals cheap to ship.
Get Started